近期在 OpenCode 和 OpenRouter 参与匿名测试的模型 ox-alpha,正式身份已经揭晓:它就是智谱发布的 GLM-5.3-Flash。
如果只看“3200 亿总参数、180 亿激活参数”,很容易把它理解为 GLM 系列又一款低成本模型。但 GLM-5.3-Flash 更值得关注的地方,是它把稀疏激活、混合注意力、原生视觉和推理系统优化放在同一条产品主线上:压低 Agent 完成一次完整任务的综合成本,而不只是单次模型调用的成本。
这也决定了它的适用边界:高频调用的代码 Agent、自动化工作流和超长上下文任务值得优先测试;普通消费级设备上的本地部署,则不是它的目标场景。
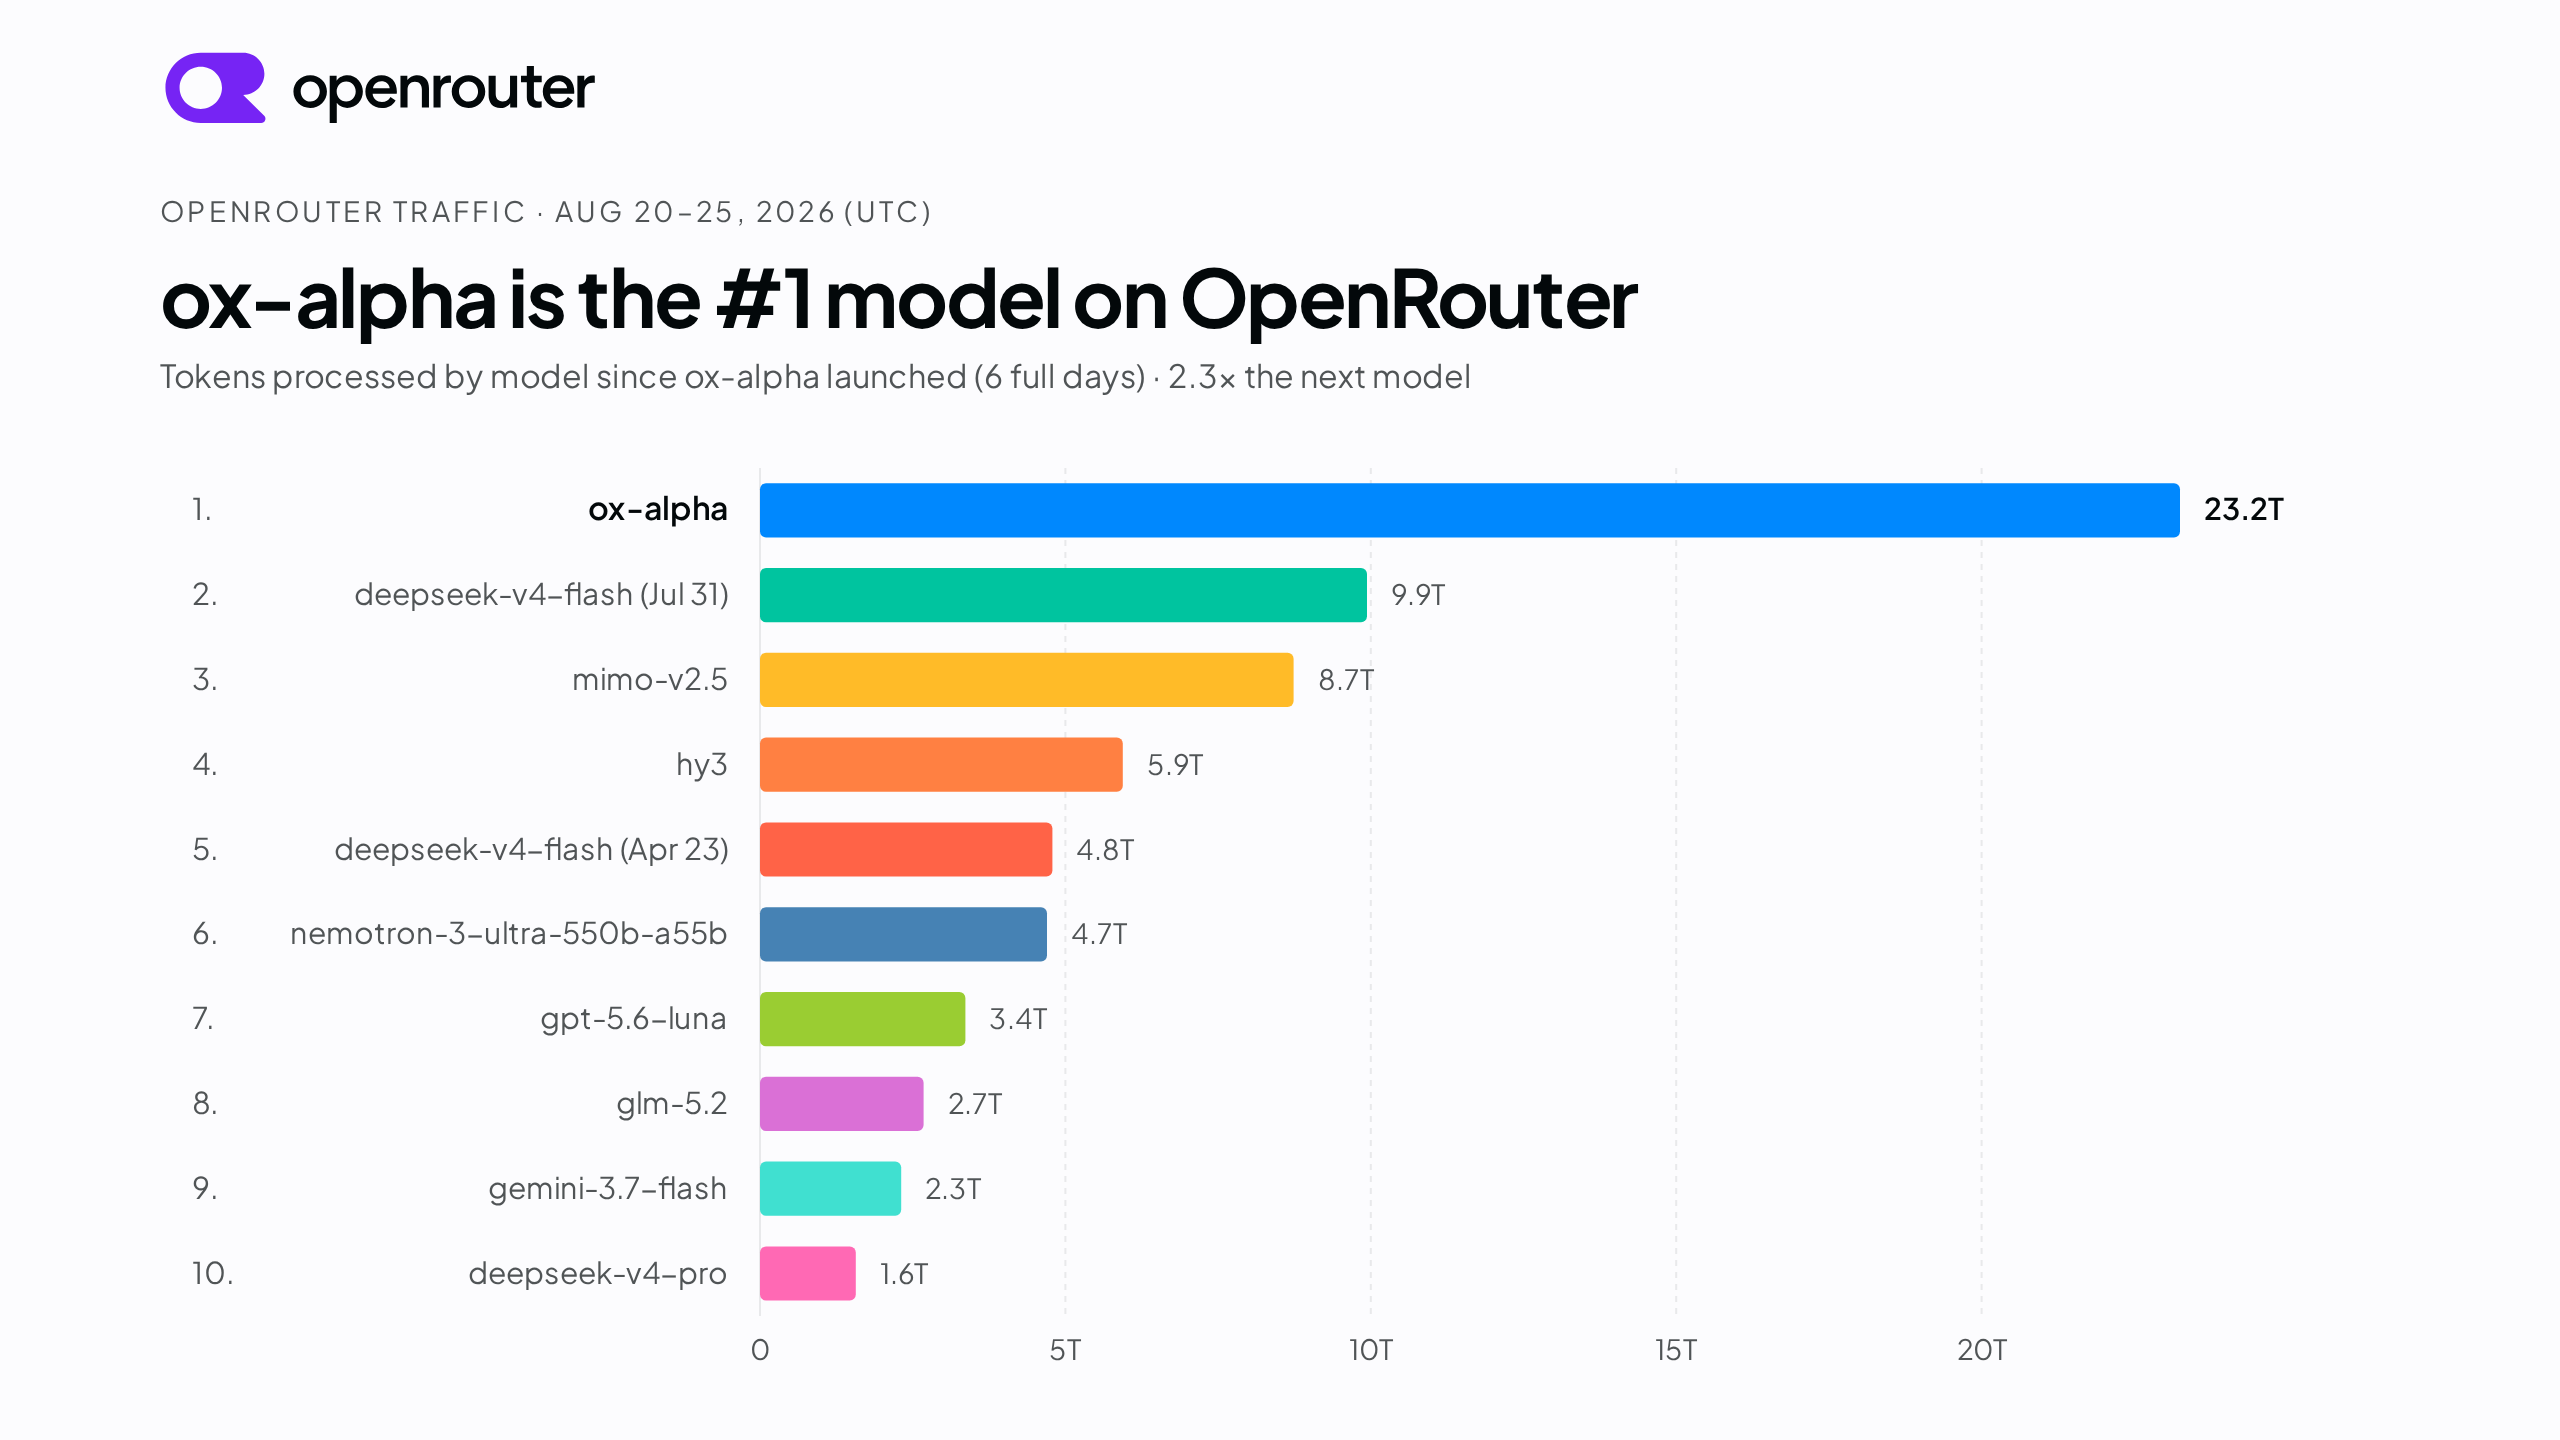
图 1:GLM-5.3-Flash 在匿名测试期间使用 ox-alpha 名称。
320B 总参数,为什么只激活 18B
GLM-5.3-Flash 是一款混合专家模型,总参数量为 320B,但一次前向计算只激活约 18B 参数。和 GLM-4.5 系列相比,它在总参数量接近的情况下,将激活参数和模型层数都大幅压低:
| 模型 | 总参数 | 激活参数 | 层数 |
|---|---|---|---|
| GLM-5.3-Flash | 320B | 18B | 45 |
| GLM-4.5 | 355B | 32B | 92 |
总参数决定模型可以容纳多少知识与专家能力,激活参数则更接近一次推理实际参与计算的规模。18B 激活参数带来的直接价值,是降低每个生成步骤的计算负担,使模型更适合代码 Agent 这类调用频率高、输出链路长的场景。
不过需要特别区分两件事:激活参数少,不等于只需加载 18B 参数的权重。 推理时仍需保存或访问完整专家权重;18B 主要描述计算路径,而不是显存和存储需求。
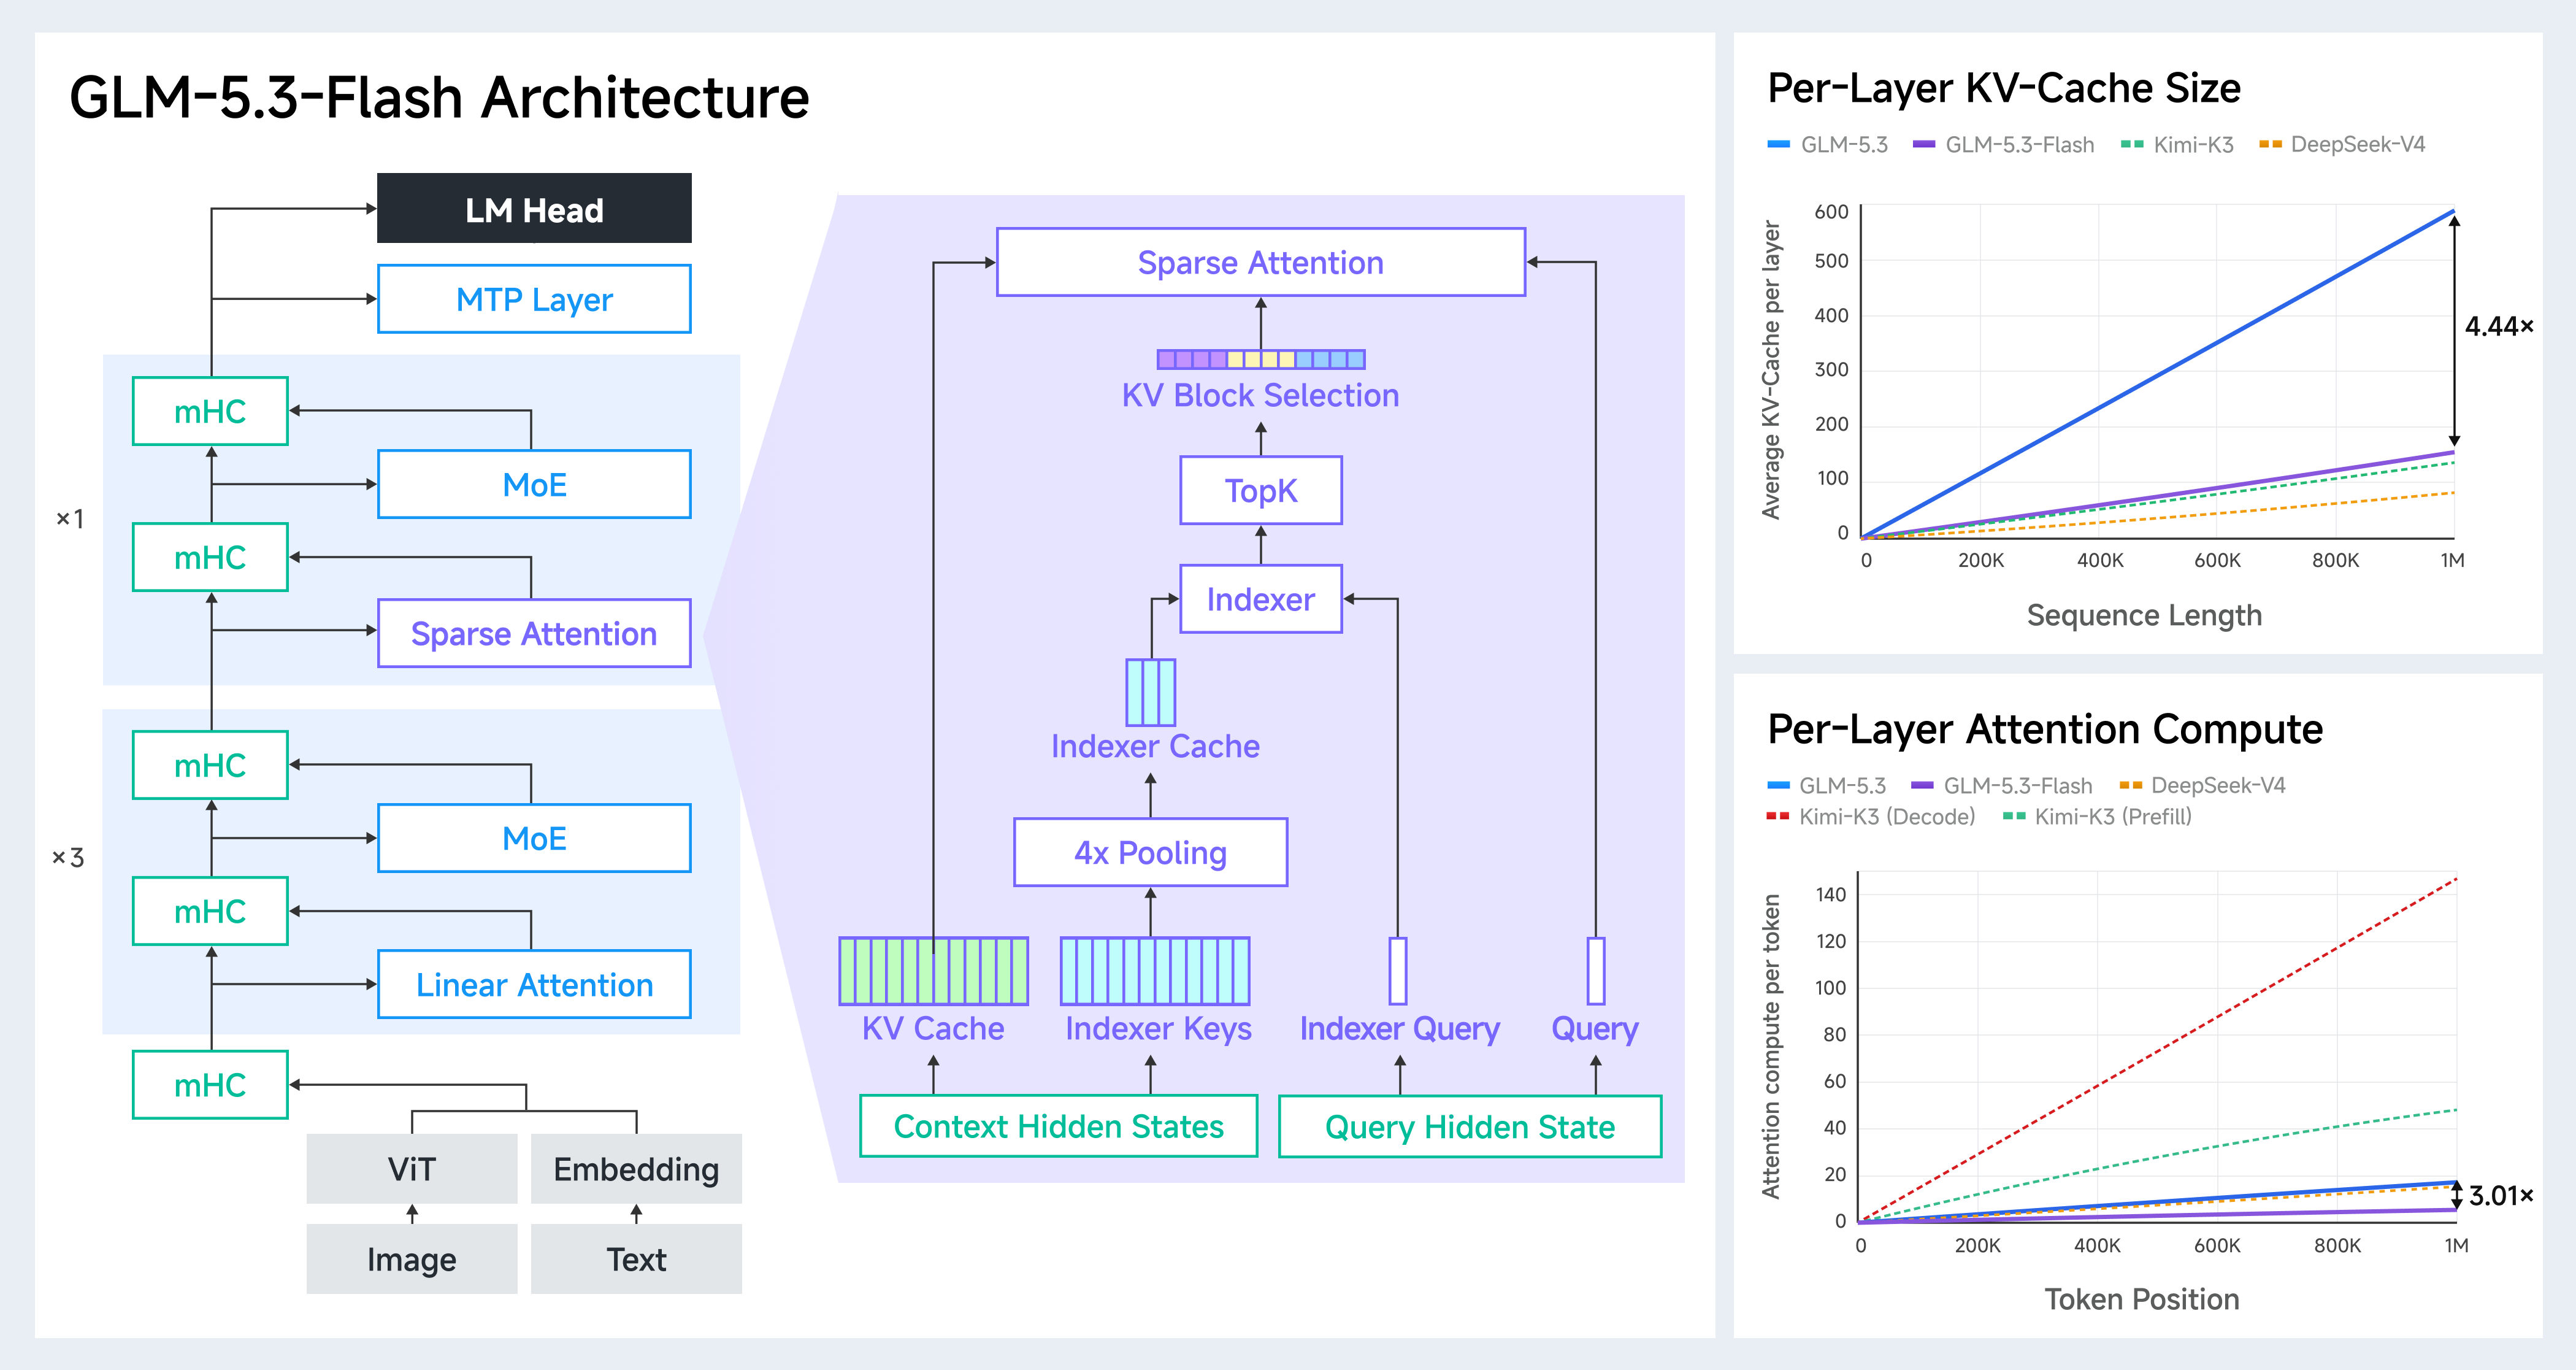
图 2:GLM-5.3-Flash 与 GLM-4.5 系列的参数及层数对比。
原生视觉的价值,是形成反馈闭环
GLM-5.3-Flash 是 GLM-5 系列首个原生多模态模型。它的视觉能力不只是“看懂一张图”,还可以进入 Agent 的执行与验证过程。
以前端开发为例,模型生成代码后,可以读取页面的实际渲染结果,发现布局错位、文字遮挡或视觉效果不协调等问题,再继续修改代码:
生成代码 → 渲染页面 → 读取画面 → 定位问题 → 修改并再次验证
图 3:模型执行视觉检查前的页面。
图 4:模型根据渲染结果修改后的页面。
这里真正有价值的不是一次图片理解,而是“生成—观察—修正—复核”的循环。它可以延伸到浏览器操作、电脑控制、演示文稿、电子表格和 PDF 等任务。
但这个闭环不会仅靠模型自动出现。Agent 的 Harness 仍需提供浏览器或桌面环境、截图工具、执行结果回传和重试机制。只在普通对话接口里上传一张截图,并不能等同于完整的视觉 Agent 工作流。
编程与 Agent 评测:优势集中,但并非全面领先
智谱公布的结果显示,GLM-5.3-Flash 相比 GLM-5.2,在编程、终端操作和工具调用上均有明显提升。下表中的分数越高越好:
| 评测项目 | GLM-5.3-Flash | GLM-5.2 | Claude Opus 4.8 |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | 85.0 |
| DeepSWE 1.1 | 63.4 | 46.2 | 58.0 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 |
| AutomationBench 1.0.6 | 48.8 | 26.2 | 41.0 |
| NL2Repo | 56.3 | 48.9 | 69.7 |
从结果看,它在 DeepSWE、Toolathlon Verified 和 AutomationBench 上超过 Claude Opus 4.8,在 Terminal-Bench 2.1 上接近后者;但 NL2Repo 仍有明显差距。更准确的结论是:GLM-5.3-Flash 在工具调用和任务执行上竞争力突出,但不能据此推导它在所有代码任务上都领先。
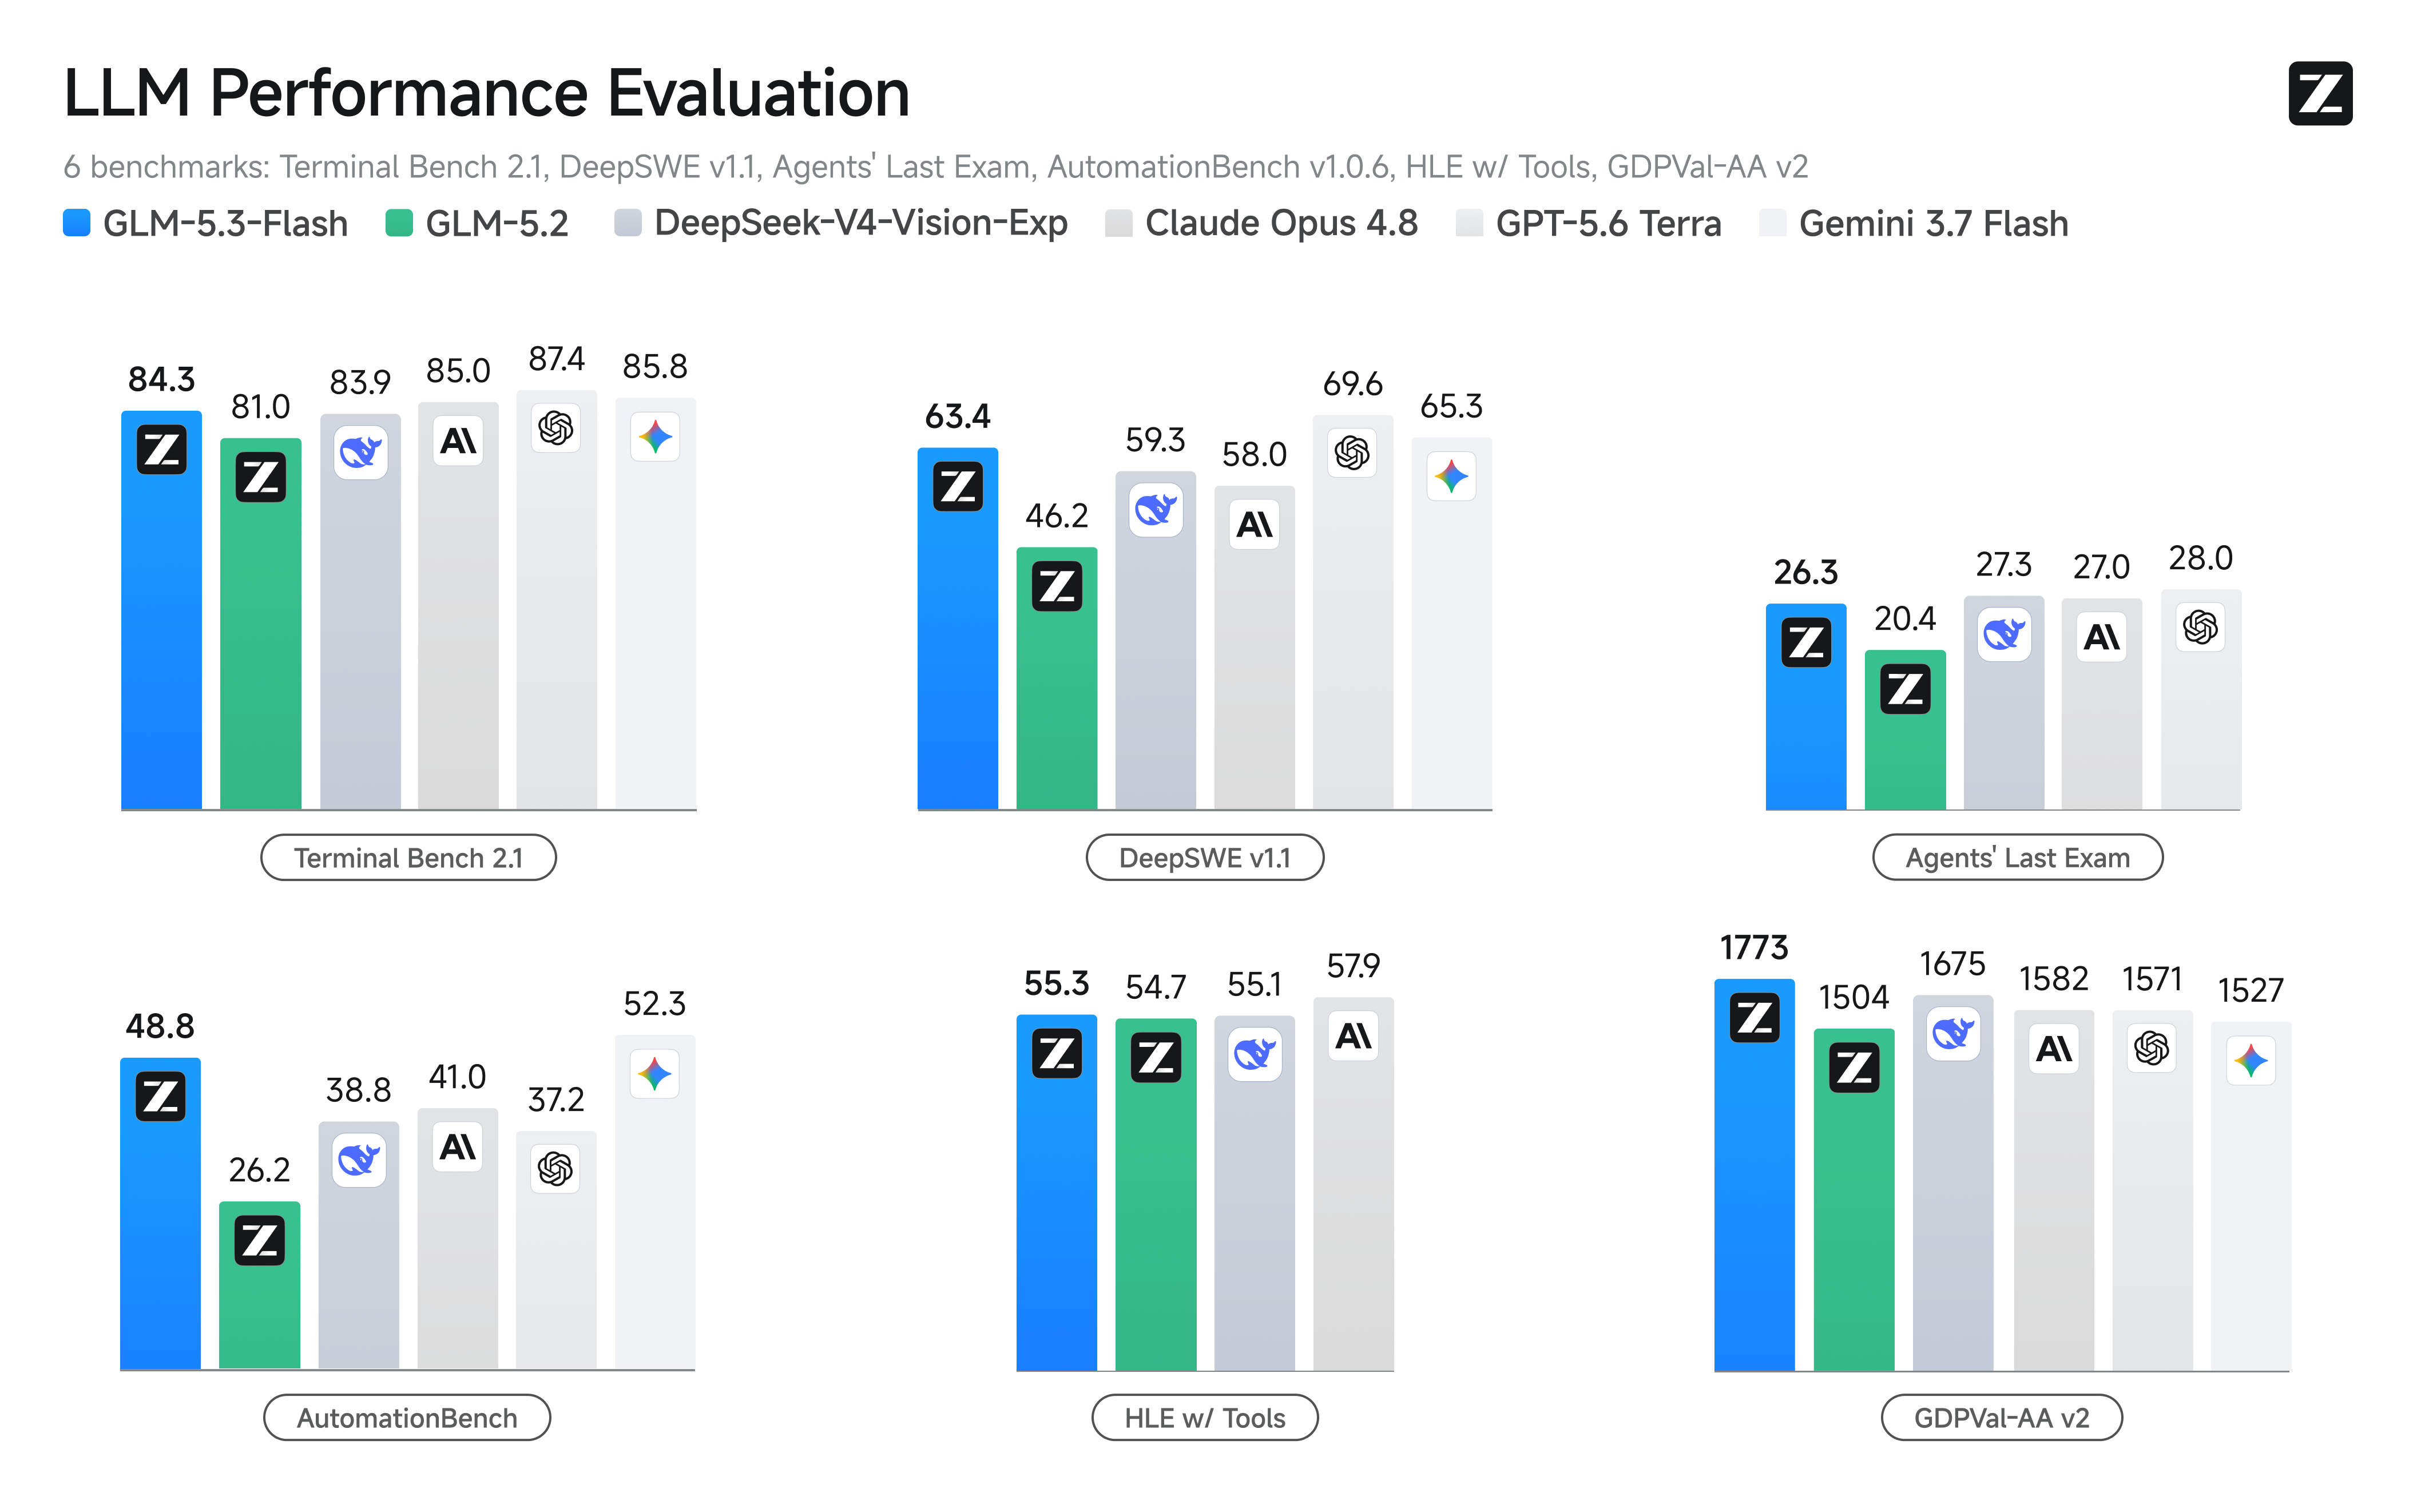
图 5:智谱公布的完整评测结果。
评测设置同样值得注意:Terminal-Bench 2.1 使用 Claude Code 2.1.207 作为 Harness;DeepSWE 使用 mini-swe-agent;不同项目的上下文长度、超时时间和采样参数也不相同。因此,这些分数反映的是“模型 + Harness + 评测配置”的组合结果,而不是脱离运行环境的纯模型排名。
此外,上述数据均来自厂商公布的评测,本文未对其进行独立复现。
混合注意力,服务于百万 Token 上下文
长代码库、复杂文档和持续运行的 Agent,会不断扩大模型需要保留的上下文。传统全注意力的计算量和 KV Cache 会随上下文快速增长,最终成为推理成本的主要来源。
GLM-5.3-Flash 采用线性注意力和稀疏注意力结合的架构。公开配置显示,45 个模型层中包含 34 个线性注意力层和 11 个稀疏注意力层:
- 线性注意力通过状态建模处理局部依赖和连续信息;
- 稀疏注意力通过轻量索引器,从长上下文中检索相关的全局信息;
- IndexPool 将 4 个索引 Key 向量加权压缩为 1 个,降低百万 Token 场景下索引器的延迟与内存开销。
模型公开配置的最大位置长度为 1,048,576。智谱以 1M Token 上下文、BF16 KV Cache 为条件进行架构测算:和 GLM-5.3 相比,GLM-5.3-Flash 的单层单头平均注意力计算量约为前者的 1/3,平均 KV Cache 约为前者的 1/4.4。
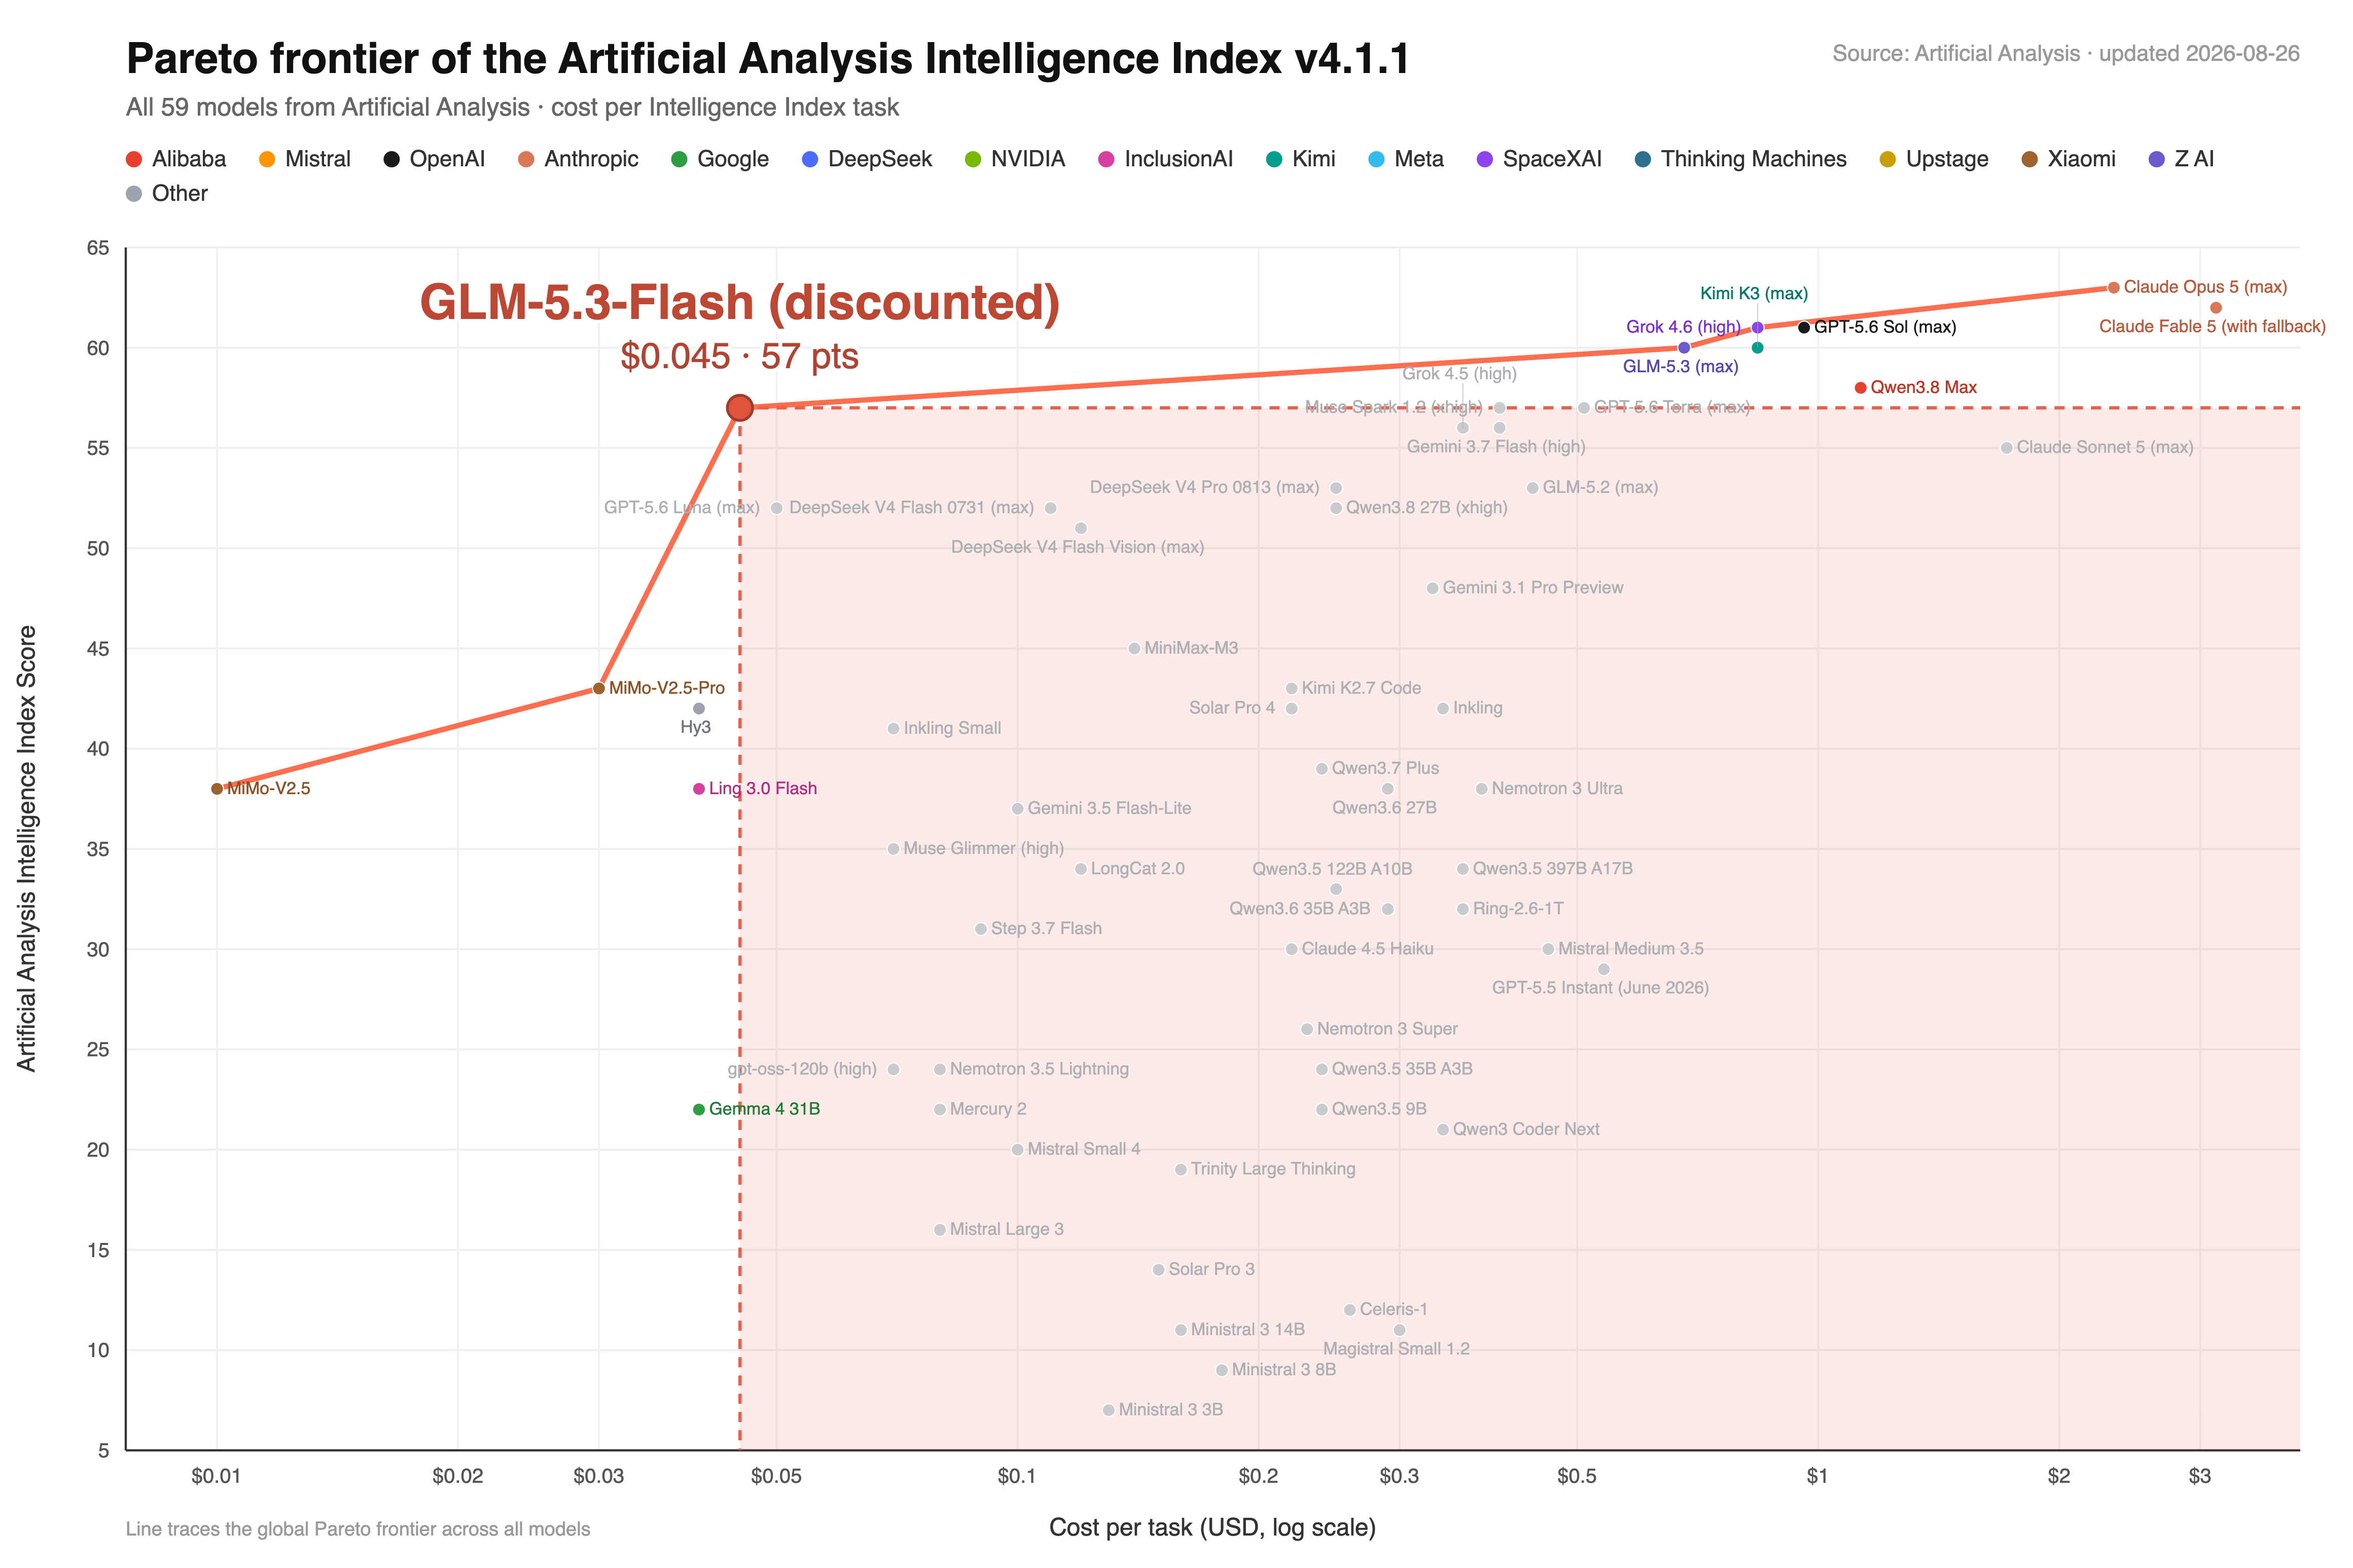
图 6:智谱对注意力计算量和 KV Cache 的测算。
这两个数字不能直接解释为“接口速度快 3 倍”或“整机显存降低 4.4 倍”。端到端性能还会受到预填充、逐 Token 解码、并发批处理、视觉编码、通信和硬件利用率等因素影响。它们更适合用于判断架构的长上下文扩展性,而不是预测一次具体请求的耗时。
国产 AI 芯片承载了匿名测试流量
ox-alpha 匿名测试期间的流量,由国产 AI 芯片集群承载。针对单卡算力、显存容量和带宽限制,智谱在 SGLang 之上为该架构开发了专用推理引擎,并使用 W8A8 量化、混合精度缓存、张量并行、Layer Split,以及多模态编码、预填充和解码分离调度等方案。
官方披露的集群规模为数万张国产加速卡。与同一硬件上的初始基线相比,优化后的系统端到端服务性能提升约 3 倍。GLM 模型也参与了相关内核开发、性能瓶颈定位和推理栈优化,形成“模型协助优化承载自身的系统”这一工程闭环。
这里的 3 倍是相对智谱内部初始基线的系统优化结果,不能理解为国产芯片与某一特定 GPU 的通用性能对比;相关数据同样来自官方披露。
开放权重,但不是消费级本地模型
GLM-5.3-Flash 已按 MIT 许可证开放权重,并支持 SGLang、vLLM、TokenSpeed 和 KTransformers 等推理框架。
截至 2026 年 8 月 26 日,Hugging Face 仓库中的 62 个 safetensors 权重分片合计约 328.34 GB(十进制),约合 305.79 GiB。实际部署还需要为 KV Cache、运行时缓冲区、视觉编码器和并行通信预留额外空间,所需显存会继续受到上下文长度、并发量和量化方式影响。
这再次说明:180 亿激活参数描述的是推理计算量,不是模型的完整加载体积。开放权重为企业私有化部署、推理优化和国产硬件适配提供了条件,但普通消费级电脑并不是它的主要部署环境。
应该怎样评估 GLM-5.3-Flash
GLM-5.3-Flash 最适合作为一个“工作负载优化模型”来评估,而不是只看总榜单名次:
| 使用场景 | 建议 |
|---|---|
| 高频代码 Agent、终端任务、自动化工作流 | 值得优先进入候选集,重点比较一次完整任务的成本和成功率 |
| 前端生成、浏览器或电脑操作 | 只有 Harness 能提供视觉反馈闭环时,原生多模态优势才能充分发挥 |
| 百万 Token 级代码库或长文档 | 值得测试,但应实测预填充时间、解码速度和峰值显存 |
| 大型仓库级代码生成 | 需要谨慎验证,官方 NL2Repo 结果仍落后于 Claude Opus 4.8 |
| 私有化部署 | 适合有服务器或多卡资源、且确有数据隔离需求的团队 |
实际 A/B 测试时,应固定 Harness、提示词、工具、上下文管理策略和超时时间,从真实业务中抽取 30–50 个任务,同时记录任务成功率、重试次数、总 Token、端到端耗时、调用费用和人工接管次数。
最终应该比较的是“完成一个任务需要付出多少成本”,而不是单次调用有多便宜。一个价格低但需要多次重试的模型,未必比价格高、一次完成的模型更省。
最后
GLM-5.3-Flash 的核心并不是把模型简单做小,而是围绕 Agent 工作负载重新分配计算:用较少的激活参数降低高频调用成本,用视觉反馈补上结果验证,用混合注意力支撑超长上下文,再通过推理系统优化把这些能力落到真实流量中。
从 ox-alpha 的匿名测试到正式发布,它代表的是一条明确的产品路线:模型不仅要生成内容,还要观察环境、调用工具、执行任务并检查结果。
对开发者而言,最实际的下一步不是根据榜单直接切换模型,而是把 GLM-5.3-Flash 放进现有 Harness,用自己的任务集验证它能否真正降低单位任务成本。
参考资料与数据说明
除权重分片体积由公开仓库文件计算得出外,文中的模型参数、评测结果和推理系统数据均来自智谱官方资料,访问日期为 2026 年 8 月 26 日。